Del boletín del SINAVE al dato de Dengue listo para modelar
El equipo de EpiForecast-MX extiende su pipeline al Dengue, la primera enfermedad transmitida por vector del proyecto. Construimos la serie histórica semanal del dengue confirmado (desde la semana 27 de 2018 hasta hoy) directamente de los cuadros de los boletines epidemiológicos, la dejamos lista para el modelado y ya entrenamos los cinco motores de pronóstico sobre ella, con validación temporal estricta. La serie se actualiza con cada boletín nuevo: la última semana cargada y la fecha de actualización aparecen abajo.
2018–2026
Cobertura
—
Boletines validados
32
Entidades federativas
—
Última semana
La decisión de modelado
Dengue total, no por severidad
El boletín reporta el dengue bajo la clasificación de la OMS 2009 en tres niveles de severidad. Con respaldo en una revisión de la literatura de pronóstico de dengue, decidimos modelar el dengue total (las tres categorías agregadas) y no cada severidad por separado.
A97.0 · Dengue no graveA97.1 · Con signos de alarmaA97.2 · Dengue grave
¿Por qué agregado?
El dengue grave es una fracción muy pequeña de los casos (alrededor de 0.1 a 0.2 por ciento en las Américas), lo que produce series estatales semanales casi en cero, ruidosas e intrínsecamente difíciles de pronosticar. La capacidad predictiva proviene de la autocorrelación y la estacionalidad de la serie agregada. Pronosticar la severidad es un problema de clasificación clínica, distinto del pronóstico de incidencia.
Es además el enfoque estándar en la literatura: los estudios de forecasting de dengue (incluidos los de México) pronostican casos totales, no estratos de severidad.
Del PDF al dato
Cómo extraemos el cuadro del boletín
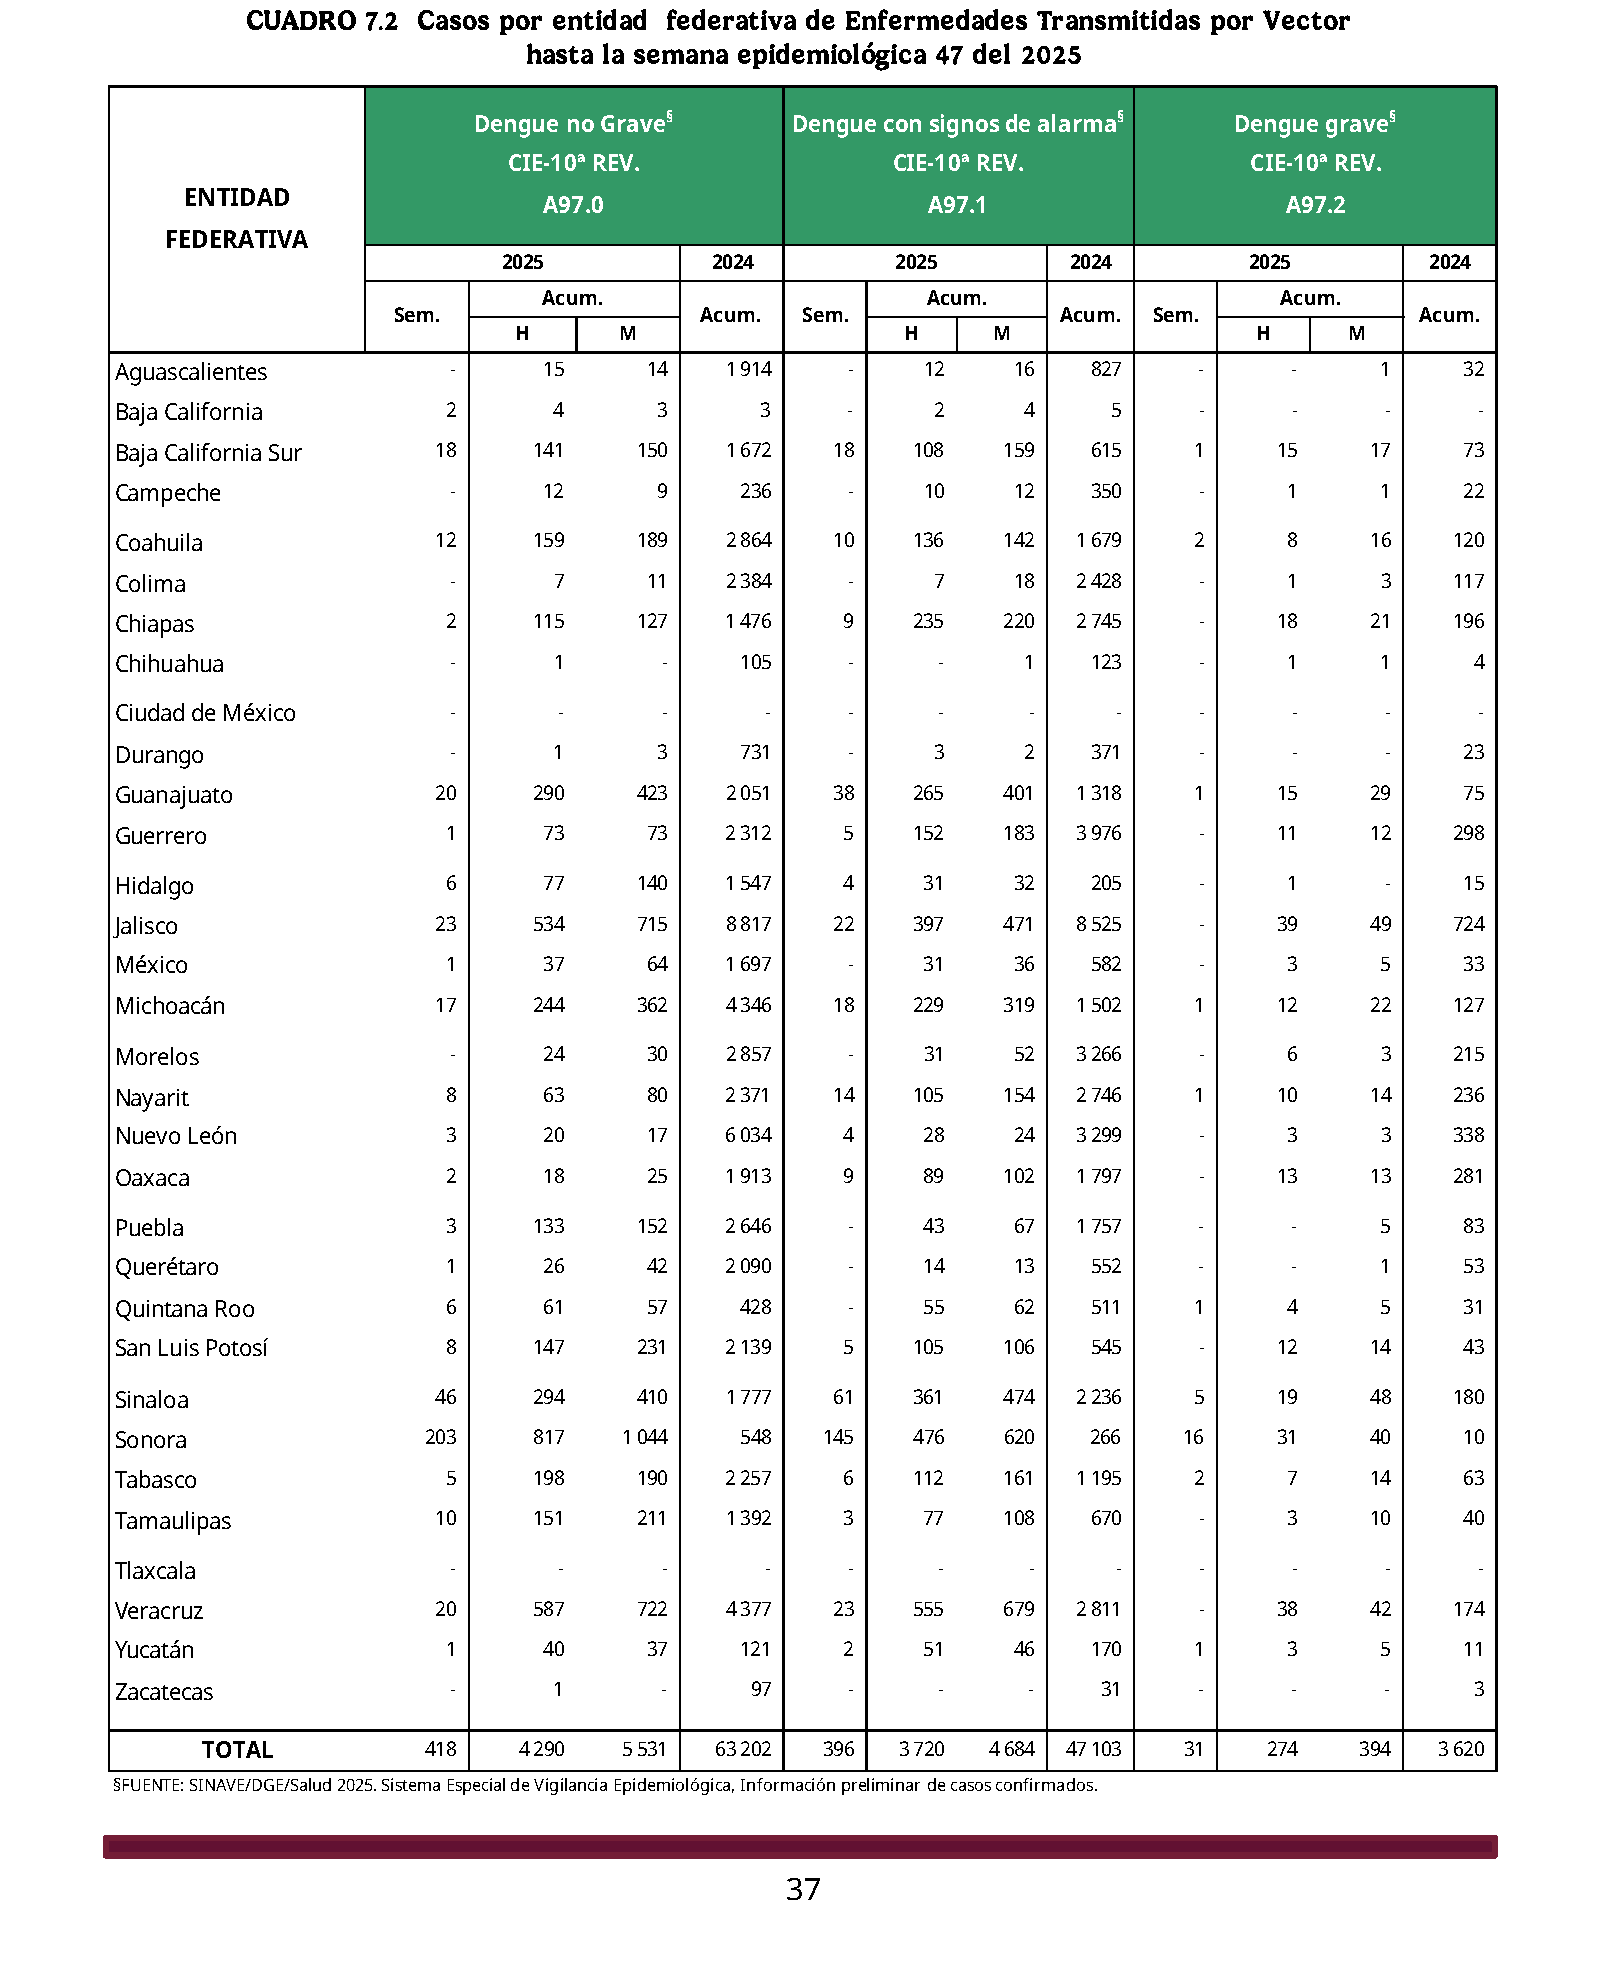
El Dengue vive en un cuadro propio del boletín (Enfermedades Transmitidas por Vector), separado del de los padecimientos neurológicos y con un diseño distinto: tres bloques de severidad, cada uno con cuatro columnas (casos de la semana, acumulado de hombres, acumulado de mujeres y acumulado del año anterior). Por cada entidad federativa hay 12 cifras que sumamos por categoría.
Cuadro 7.2 del boletín del SINAVE (semana 47, 2025). Cada estado trae 12 cifras: 3 severidades × [Sem · Acum. H · Acum. M · año anterior].
01
Localizar el cuadro
Se ancla en los códigos CIE A97.0/A97.1/A97.2 y en marcadores de entidad, estable ante los cambios de redacción del boletín entre años.
02
Extraer la tabla
Se leen las 32 filas × 12 columnas con extracción estructural de tablas y se restringe a las entidades canónicas (sin acentos ni mayúsculas que estorben).
03
Agregar severidades
Se suman las tres categorías columna por columna en un único padecimiento "Dengue" (casos de la semana y acumulados por sexo).
04
Validar contra el TOTAL
La suma de las 32 entidades debe cuadrar con el renglón TOTAL impreso en el propio boletín (con tolerancia para erratas tipográficas).
05
Rechazar artefactos
Una validación descarta automáticamente los boletines donde la lectura duplica una columna, contrastando cada cifra contra el cuadro original del boletín.
06
Fechar con el archivo
El año y la semana se toman del nombre del boletín (fuente autoritativa), evitando desfases del texto de la página.
Cuánta historia
De 2018 a 2026: ocho temporadas de dengue
La clasificación de la OMS 2009 (A97.x, la misma de producción) aparece en los boletines desde la semana 27 de 2018. Extendimos el extractor para leer también ese formato más antiguo (un cuadro de 10 columnas, distinto al de 12 de 2020 en adelante), validándolo celda por celda contra el renglón TOTAL impreso. Eso sumó 72 semanas verificadas y llevó la serie de modelado a 392 semanas (2018-W27 a 2026): más ciclos anuales para que los modelos aprendan la estacionalidad, en especial DeepAR.
392
Semanas de modelado
+72
Semanas ganadas (2018-19)
8
Temporadas anuales
2018–2026
Cobertura A97.x
El esquema viejo (2014 a mediados de 2018), aparte
Antes de la semana 27 de 2018, el boletín reportaba el dengue con la clasificación de la OMS 1997 (A90 dengue clásico, A91 hemorrágico), en un cuadro por estatus de caso (confirmados y en estudio). Lo recuperamos también (226 semanas validadas, de 2014 a 2018) pero como una serie histórica nacional separada, NO mezclada con la de modelado.
Mezclar dos taxonomías y dos definiciones de caso introduciría un salto artificial que ensuciaría lo que aprende el modelo. Esa serie antigua queda como contexto histórico, no como insumo de entrenamiento.
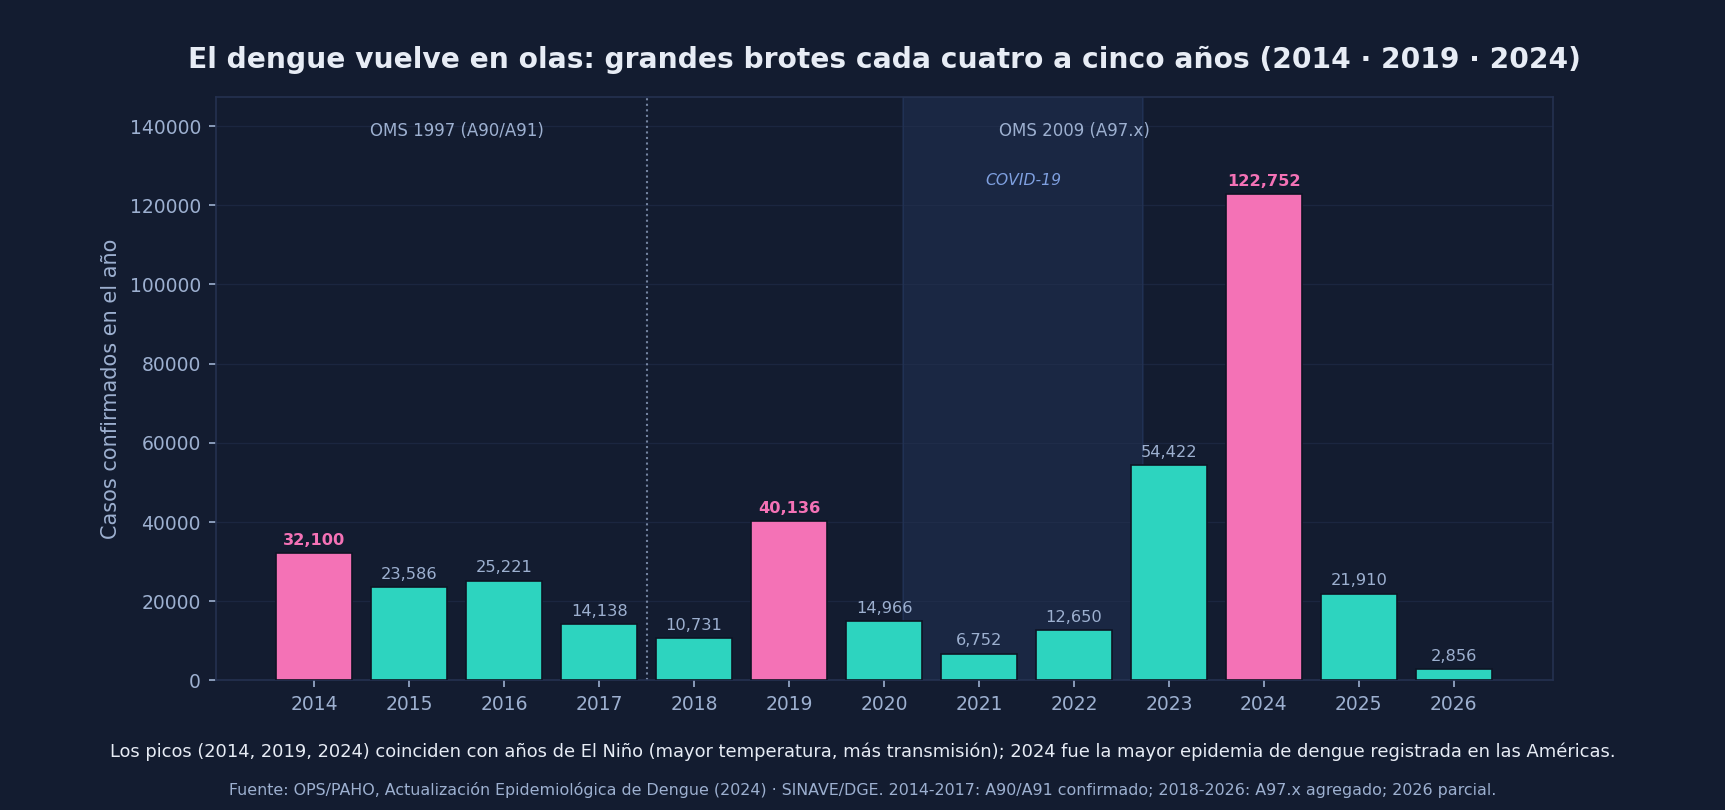
Total anual de dengue confirmado, 2014-2026. Los grandes brotes (en rosa) llegan en olas de aproximadamente cuatro a cinco años (2014, 2019, 2024); 2024 fue la mayor epidemia registrada en las Américas. El dengue mantuvo su ciclo natural durante la pandemia (franja COVID-19 sombreada). Haz clic para ampliar.
Gráficos preliminares
Lo que ya muestra la serie
Visualizaciones exploratorias de la serie validada (2018 a 2026). No son pronósticos: ilustran la señal estacional, la geografía y la magnitud que los modelos deben capturar.
¿Por qué arrancan en 2018 y no en 2014? Estos gráficos usan la serie de modelado, con la clasificación homogénea OMS 2009 (A97.x). La historia completa desde 2014 sí la tenemos y se muestra en la gráfica de ciclo de más arriba, donde la línea punteada marca el cambio de clasificación: el tramo 2014-2017 (OMS 1997, A90/A91) se conserva como contexto, no como insumo de entrenamiento, porque mezclar dos definiciones de caso introduciría un salto artificial.
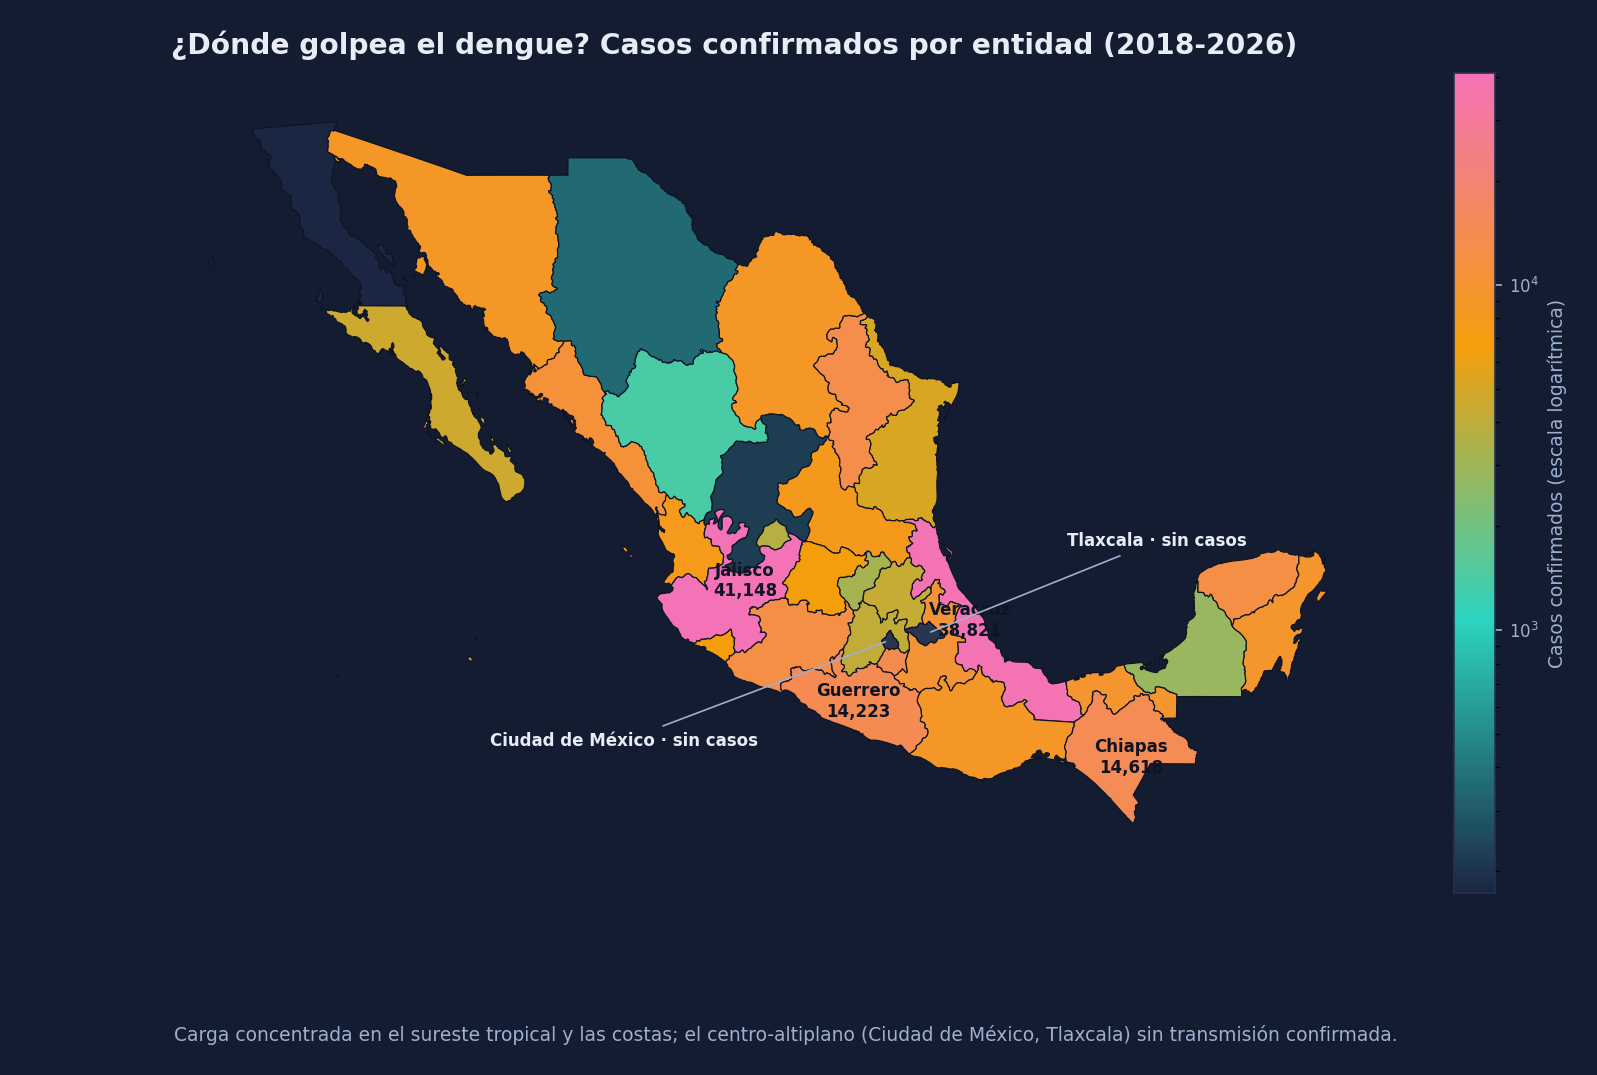
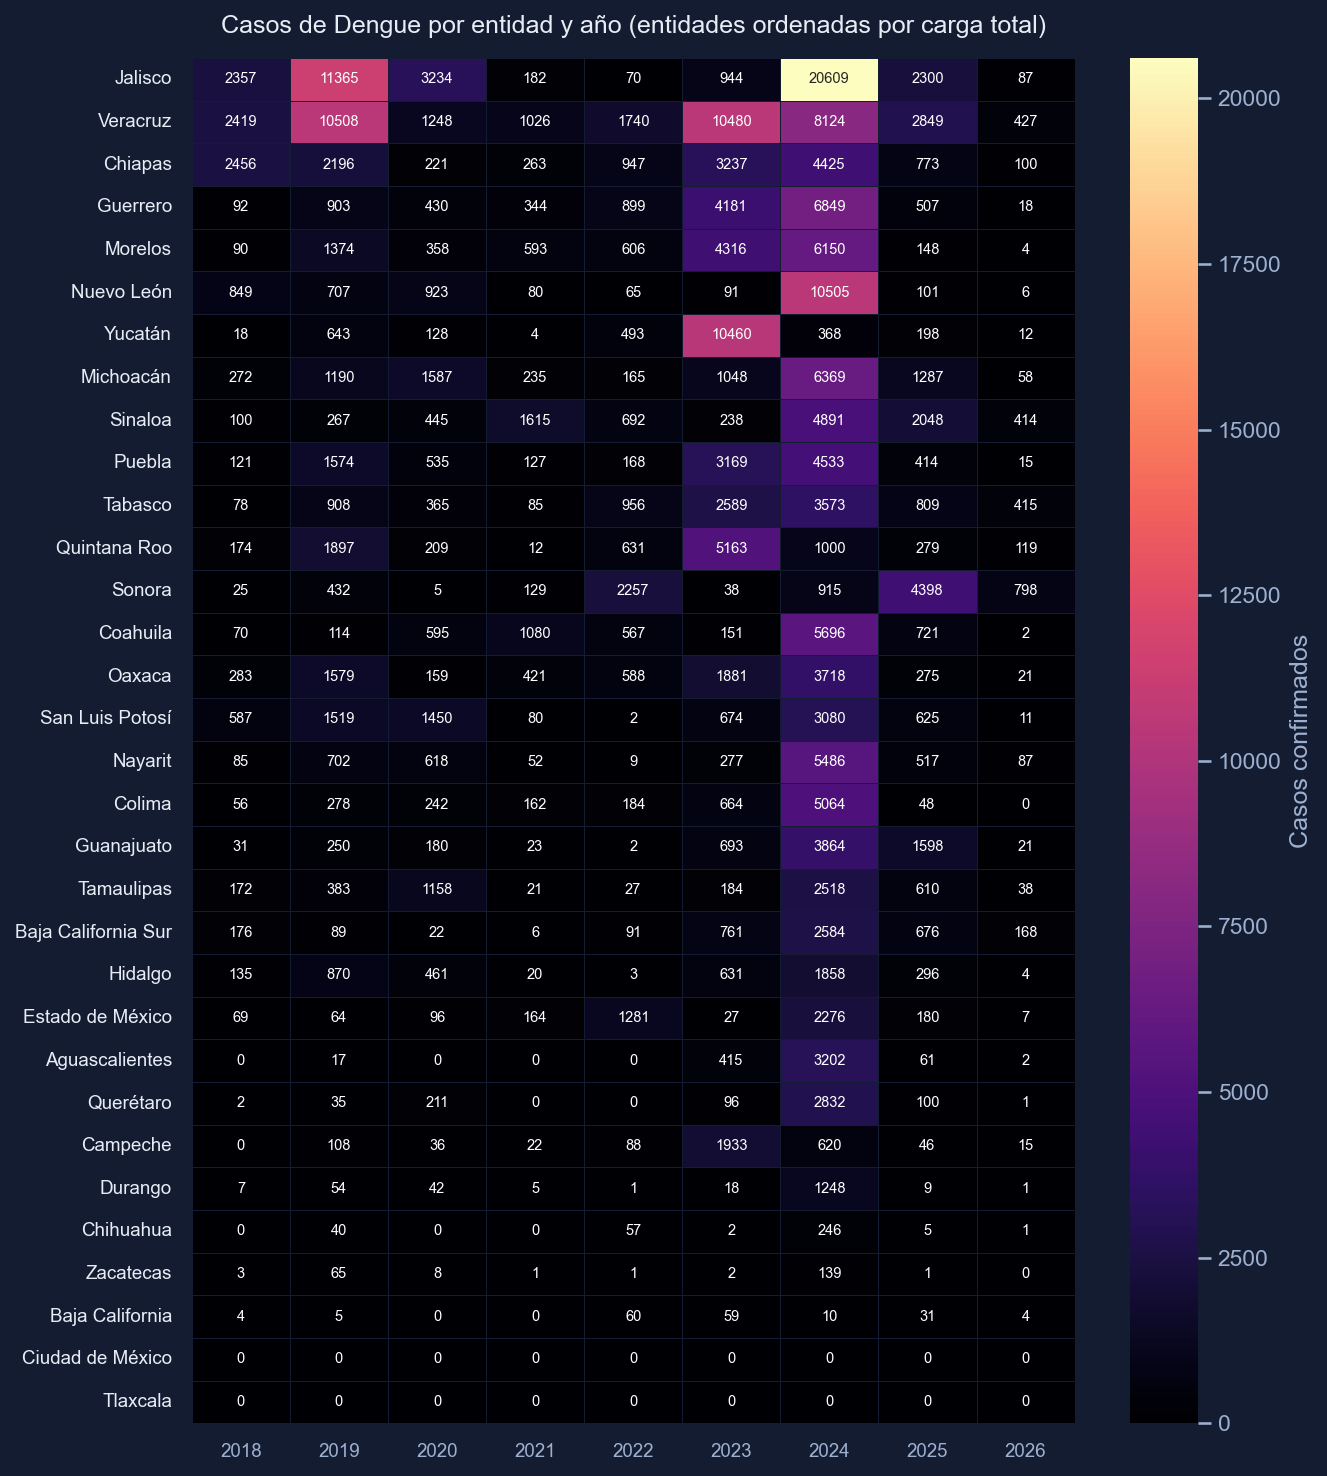
Geografía del dengue: el sureste tropical y la costa del Pacífico concentran la carga (Jalisco, Veracruz, Chiapas, Guerrero); el centro-altiplano (Ciudad de México, Tlaxcala) queda sin transmisión confirmada. Escala logarítmica. Haz clic para ampliar.
Incidencia semanal nacional (interactivo, en vivo): pasa el cursor para ver los casos de cada semana. Brotes anuales marcados, con el pico epidémico de 2024.
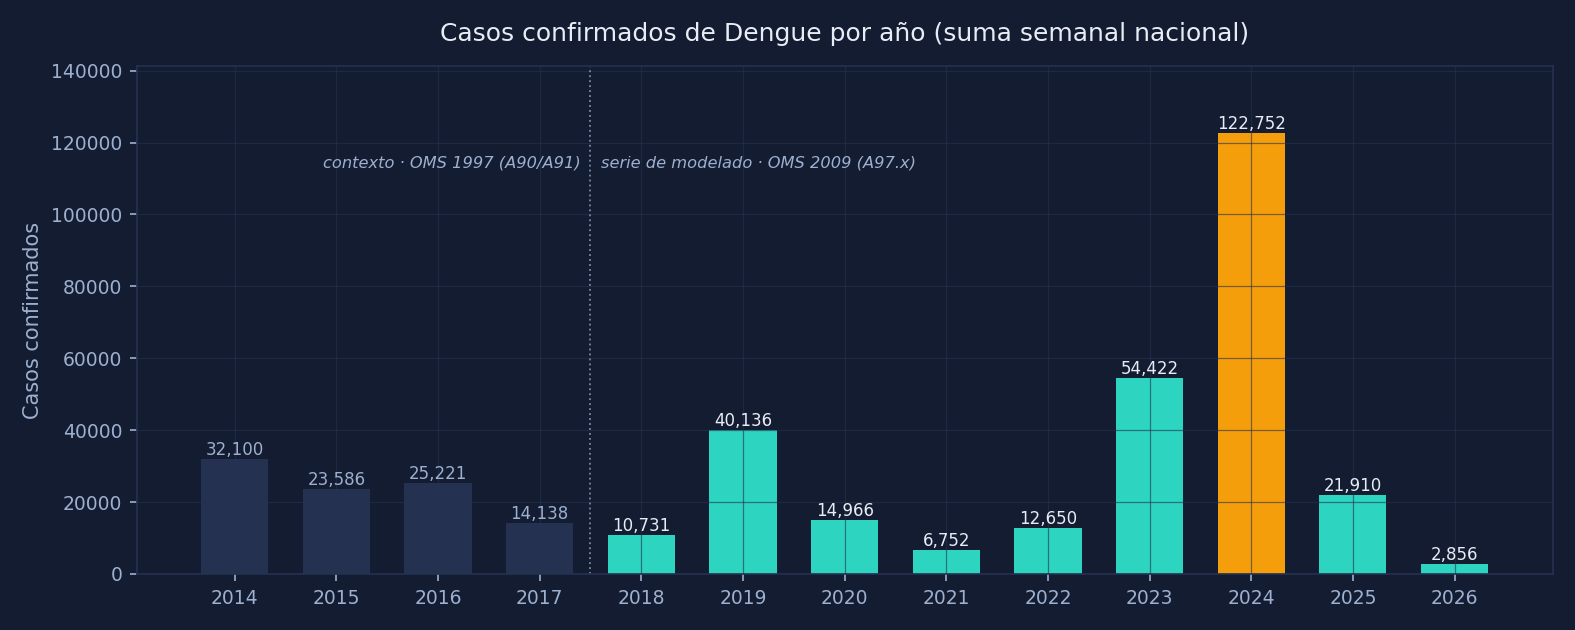
Casos confirmados por año (2014-2026): 2024 resalta como el año epidémico del periodo. Las barras atenuadas de 2014-2017 son contexto del esquema viejo (A90/A91), no insumo de modelado.
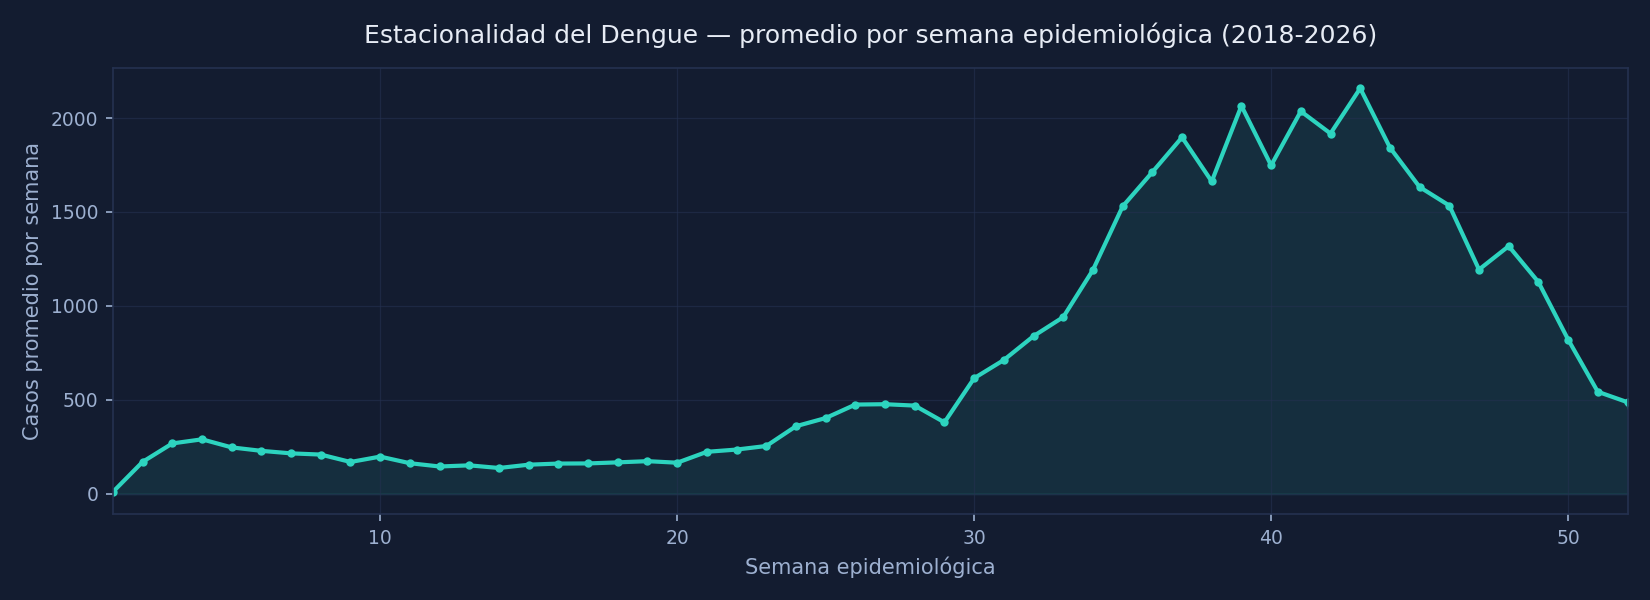
Estacionalidad promedio: la carga se concentra en la segunda mitad del año epidemiológico.
Qué pasó en 2024: la mayor epidemia de dengue registrada
El pico de 2024 no fue un año alto cualquiera: fue la peor epidemia de dengue jamás registrada en México y en todo el continente. La Organización Panamericana de la Salud contabilizó más de 12.6 millones de casos en las Américas (casi el triple del récord previo), y el Instituto Nacional de Salud Pública la calificó como la mayor jamás observada en el país. México cerró el año en su máximo histórico de casos confirmados (el pico que se ve en la gráfica), con Guerrero, Veracruz, Chiapas y Tabasco concentrando la carga.
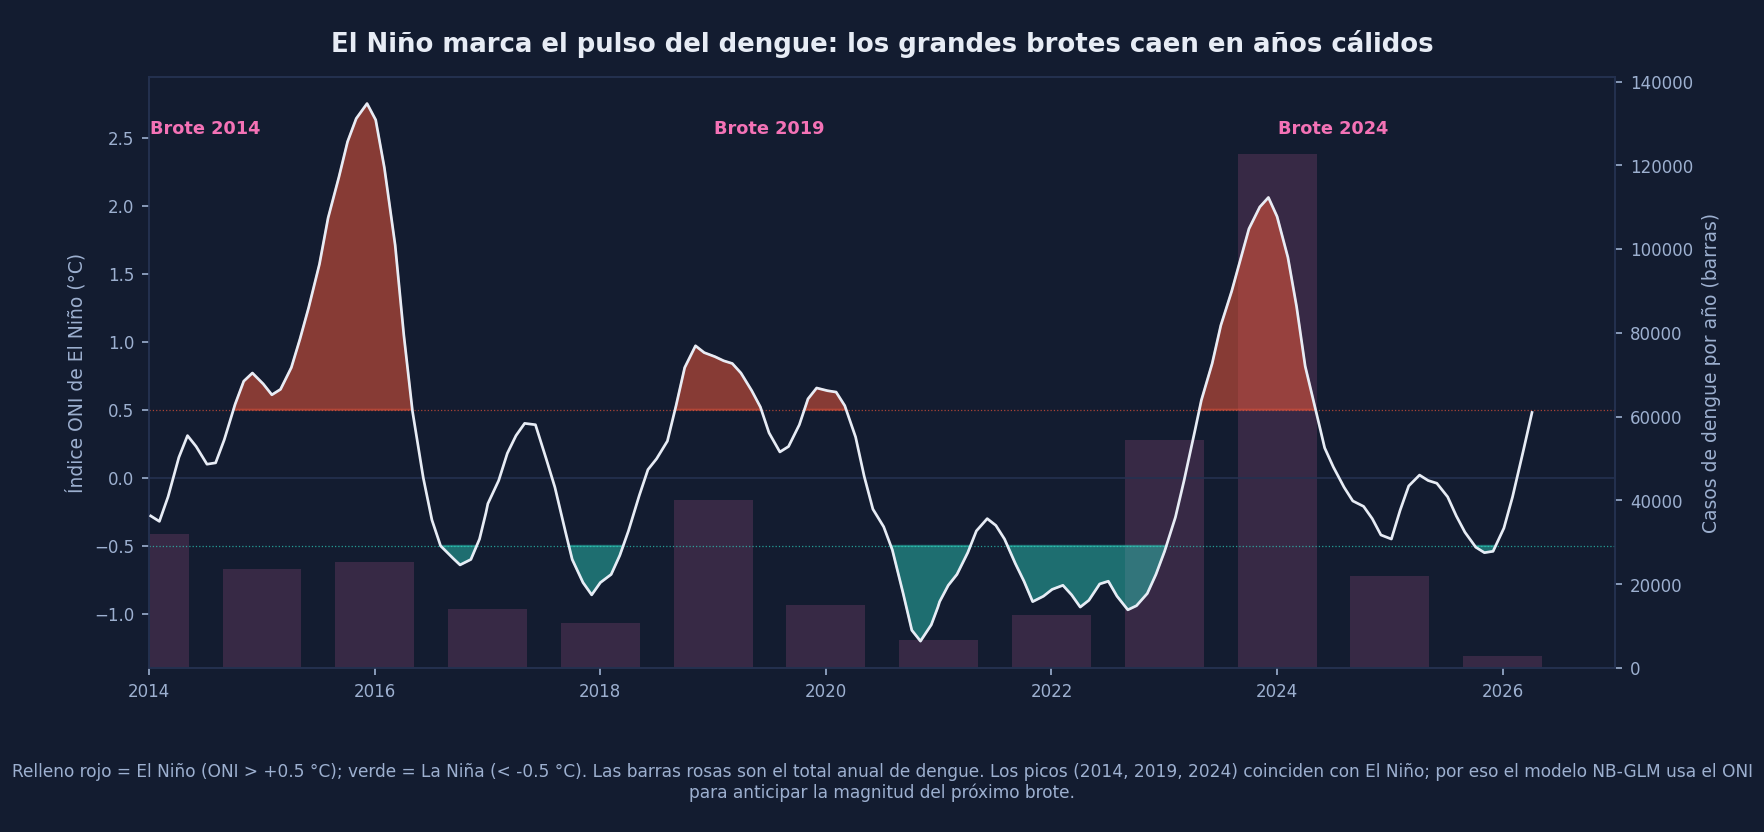
El motor de fondo fue climático: el fenómeno de El Niño de 2023-2024 elevó las temperaturas y extendió la temporada y el rango del mosquito Aedes aegypti. (Es exactamente la señal que el modelo NB-GLM incorpora con su regresor de El Niño para anticipar la magnitud del próximo brote.)
El contexto político-económico amplificó la presión sobre la respuesta. 2024 fue un año electoral y de transición de gobierno (elecciones en junio, cambio de administración el 1 de octubre), y el sistema de salud llegó al brote debilitado: el Centro de Investigación Económica y Presupuestaria documentó subejercicios del presupuesto de salud cercanos al 50% en 2023, y la reorganización del aseguramiento público (Seguro Popular hacia IMSS-Bienestar) tensó la vigilancia y el control vectorial justo cuando más se necesitaban. En 2025, ya con una Estrategia Nacional contra el dengue, los casos cayeron alrededor de 85%. Fuentes: INSP y Panorama Epidemiológico de Dengue 2024 (Secretaría de Salud).
El Niño y el pulso del dengue. El relleno rojo marca los periodos de El Niño (índice ONI por encima de +0.5 °C) y el verde los de La Niña; las barras al fondo son el total anual de dengue. Los tres grandes brotes (2014, 2019, 2024) caen en años cálidos: el calor extiende la temporada y el rango del mosquito. Esta es la señal inter-anual que se estudia como regresor climático del pronóstico. Haz clic para ampliar.
Fase 2 · Análisis y preparación
Del dato al modelo: análisis y preparación
Con la serie ya validada, la siguiente fase es dejarla lista para el pronóstico: entenderla (EDA), integrarla y limpiarla, y afinar el feature engineering a la naturaleza del dengue (una arbovirosis con estacionalidad climática y brotes), no a la de los padecimientos neurológicos. Estas son las decisiones tomadas, con su porqué.
Análisis exploratorio (EDA)
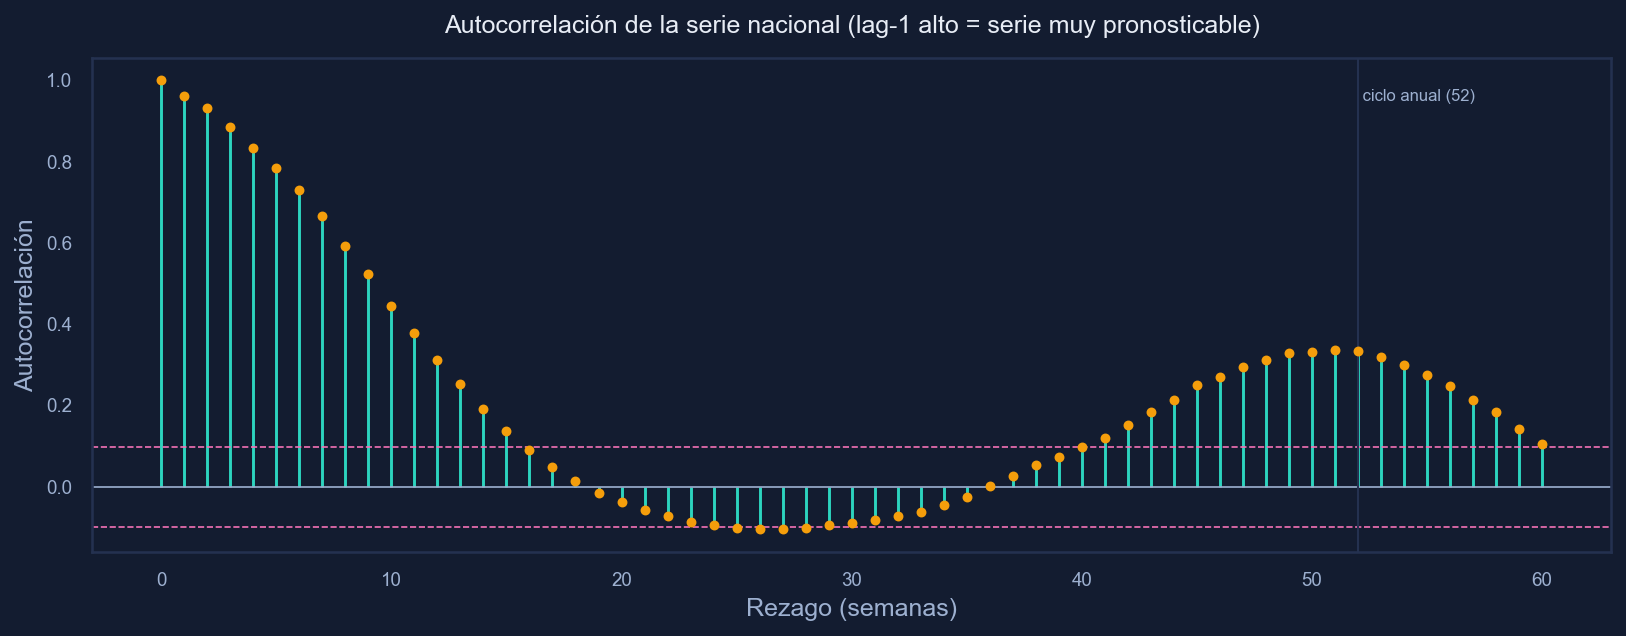
El EDA confirma que el dengue es una serie muy pronosticable y de fuerte estacionalidad, justo lo que sustenta modelarlo agregado:
0.96
Autocorrelación (semana previa)
85%
Casos en semanas 27-52
122,752
Casos en 2024 (pico)
43.7%
Semanas-estado en cero
La autocorrelación altísima (0.96 a una semana) significa que la propia historia de la serie predice bien el futuro cercano. La carga se concentra en el segundo semestre (pico promedio en la semana 43). Los años epidémicos son muy marcados (2024 fue cerca de 18 veces el año más bajo). Geográficamente, la señal vive en los estados tropicales y costeros; dos entidades (Ciudad de México y Tlaxcala) no registran dengue confirmado en todo el periodo.
Galería exploratoria completa sobre la serie validada (mapas de calor, distribuciones y autocorrelación), para verificar visualmente que el dato está sano:
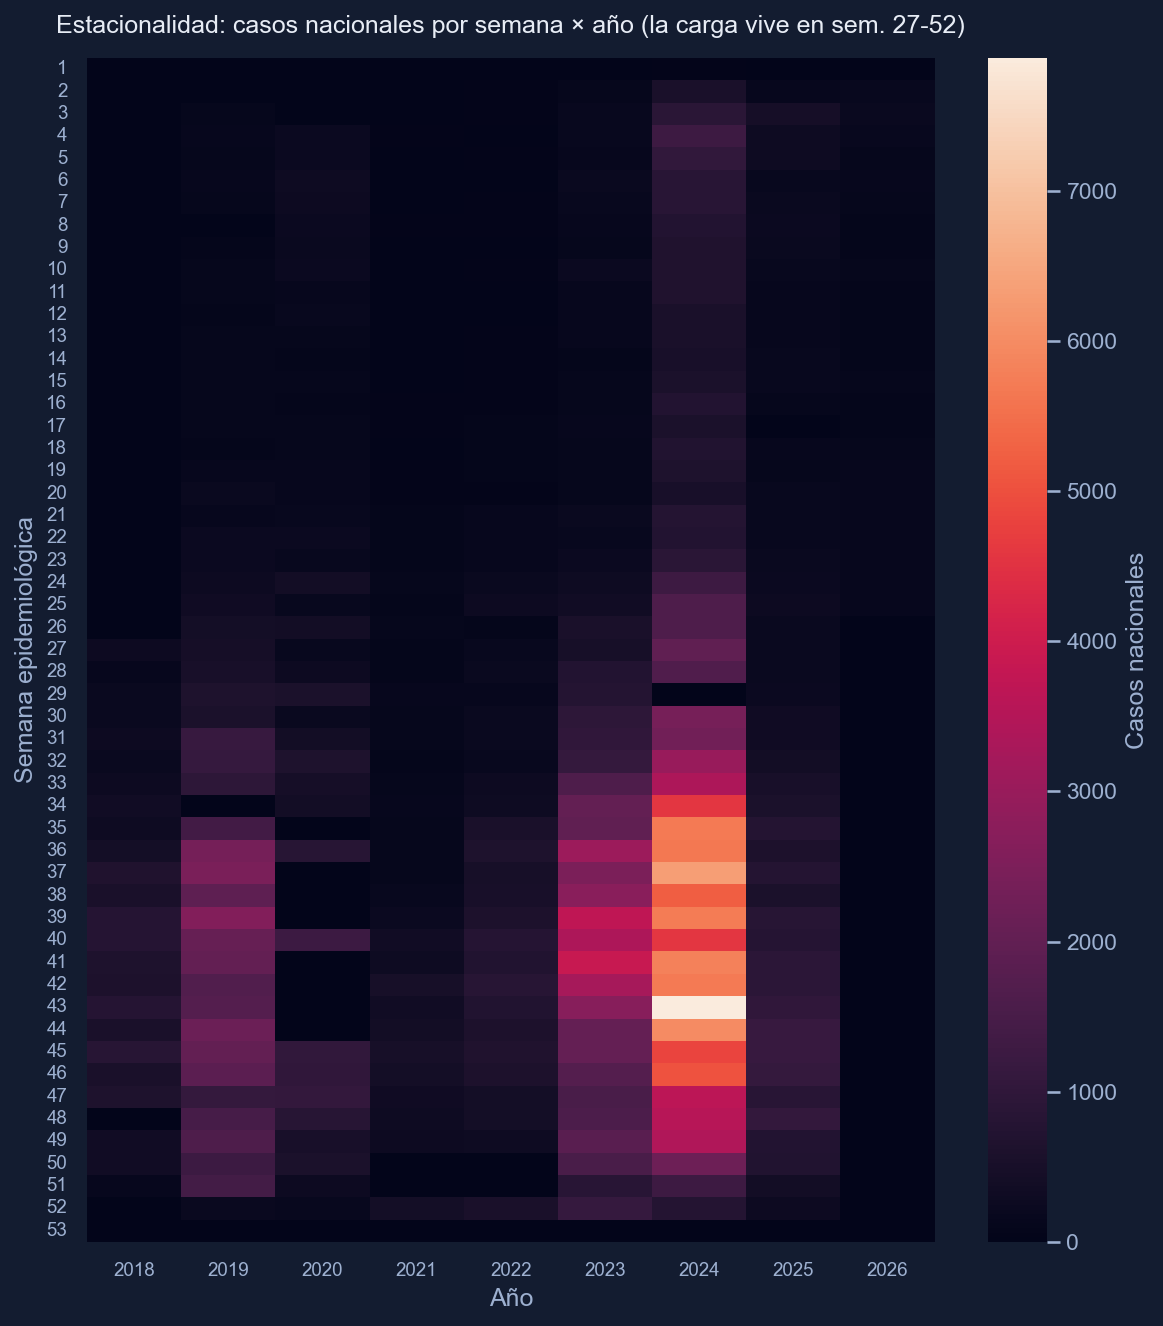
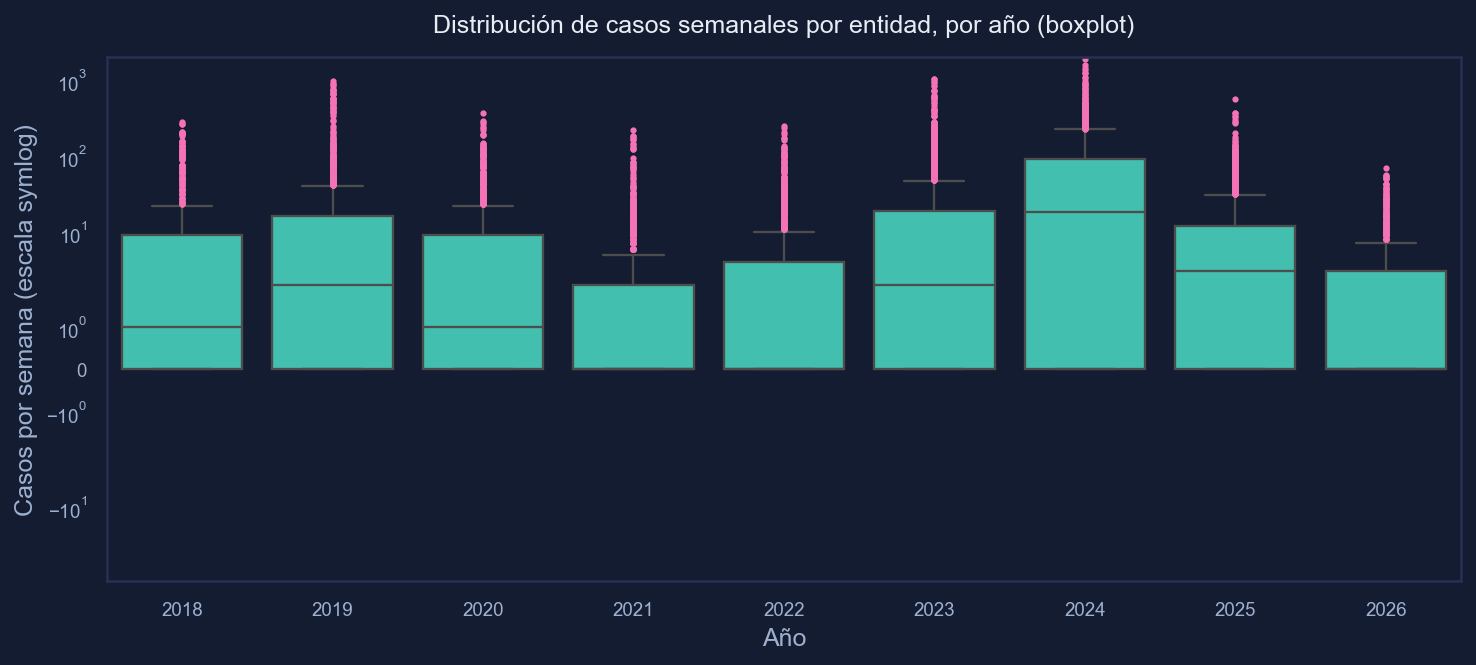
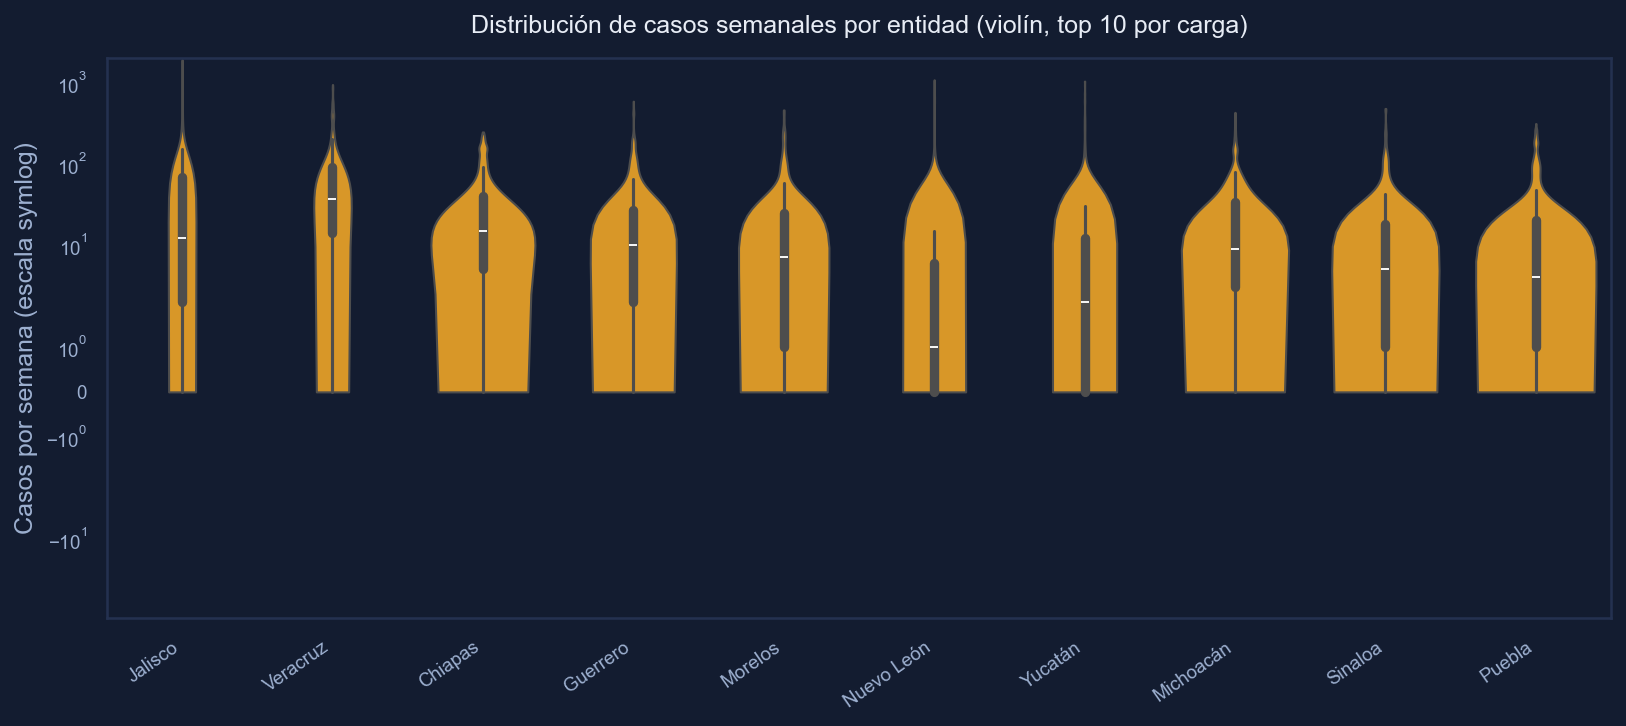
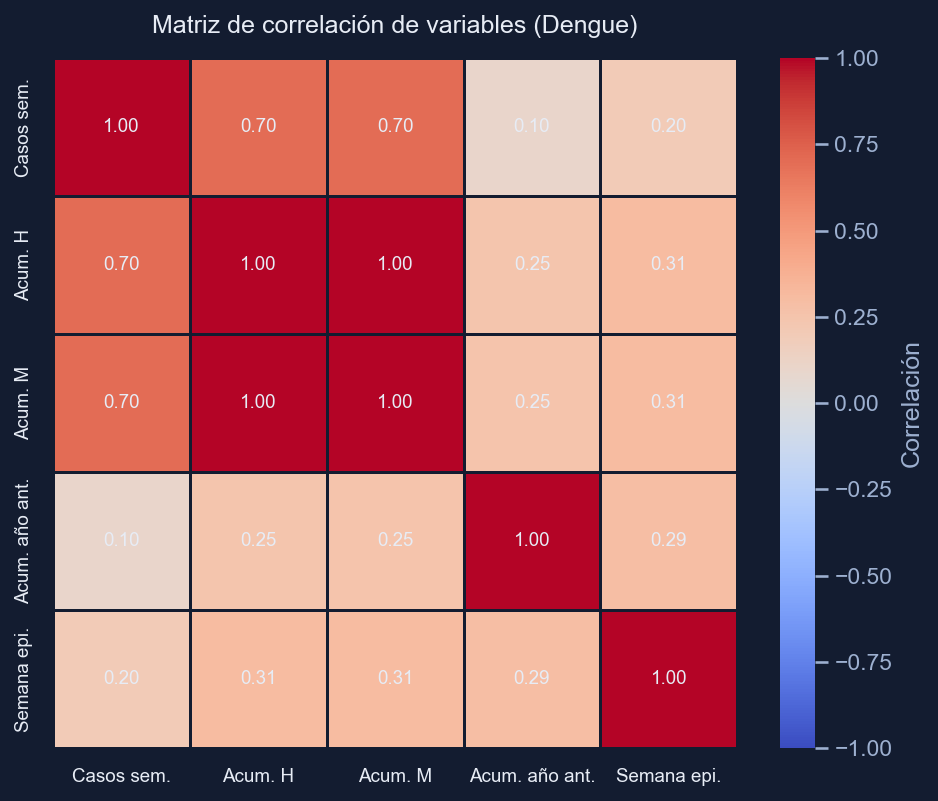
Mapa de calor por entidad y año. Los estados tropicales y costeros concentran la carga; Ciudad de México y Tlaxcala permanecen en cero; 2024 destaca como año epidémico.Mapa de calor semana × año (nacional). La carga se concentra de forma consistente en las semanas 27 a 52 de cada año.Autocorrelación: el rezago de una semana es cercano a 1 (alta predictibilidad) y hay un repunte en el rezago 52 (el ciclo anual).Diagrama de caja (bigotes) de casos semanales por año, en escala symlog: mediana, dispersión y valores atípicos. Los años epidémicos elevan toda la distribución.Diagramas de violín por entidad (las de mayor carga): muestran la forma de la distribución semanal, incluida la masa de semanas en cero (temporada baja).Matriz de correlación de variables. Los acumulados por sexo van de la mano; los casos semanales correlacionan con la semana epidemiológica (estacionalidad).
Limpieza e integración
La serie se validó celda por celda contra el cuadro original del boletín (cero duplicados, 32 entidades por semana, consistencia interna verificada). Se integró al dataset consolidado del proyecto (74,560 filas: 62,016 de los tres padecimientos neurológicos más 12,544 de Dengue), con los nombres de entidad normalizados, y se empató con la base demográfica del INEGI. La serie quedó lista para el modelado: 32 entidades, sin valores faltantes de población ni región. El Dengue se modela sobre conteos absolutos (no tasa por población): en una arbovirosis con niveles muy bajos en temporada baja, normalizar a tasa comprime la señal y degrada el pronóstico.
Una corrección de fuente: Zacatecas 2024
Nuestra validación detectó un error de captura en el propio boletín: en la semana 41 de 2024, el acumulado de "dengue con signos de alarma" para Zacatecas aparecía impreso como 14,522 hombres / 17,657 mujeres, una cifra imposible para un estado de incidencia casi nula. Lo corregimos a un valor consistente con los casos semanales validados (que daban 19 esa semana) y con las semanas vecinas.
La corrección queda documentada y es reproducible (no se "esconde" el dato): así un solo error de captura no contamina la señal que aprenderá el modelo.
Outliers: el pico ES la señal
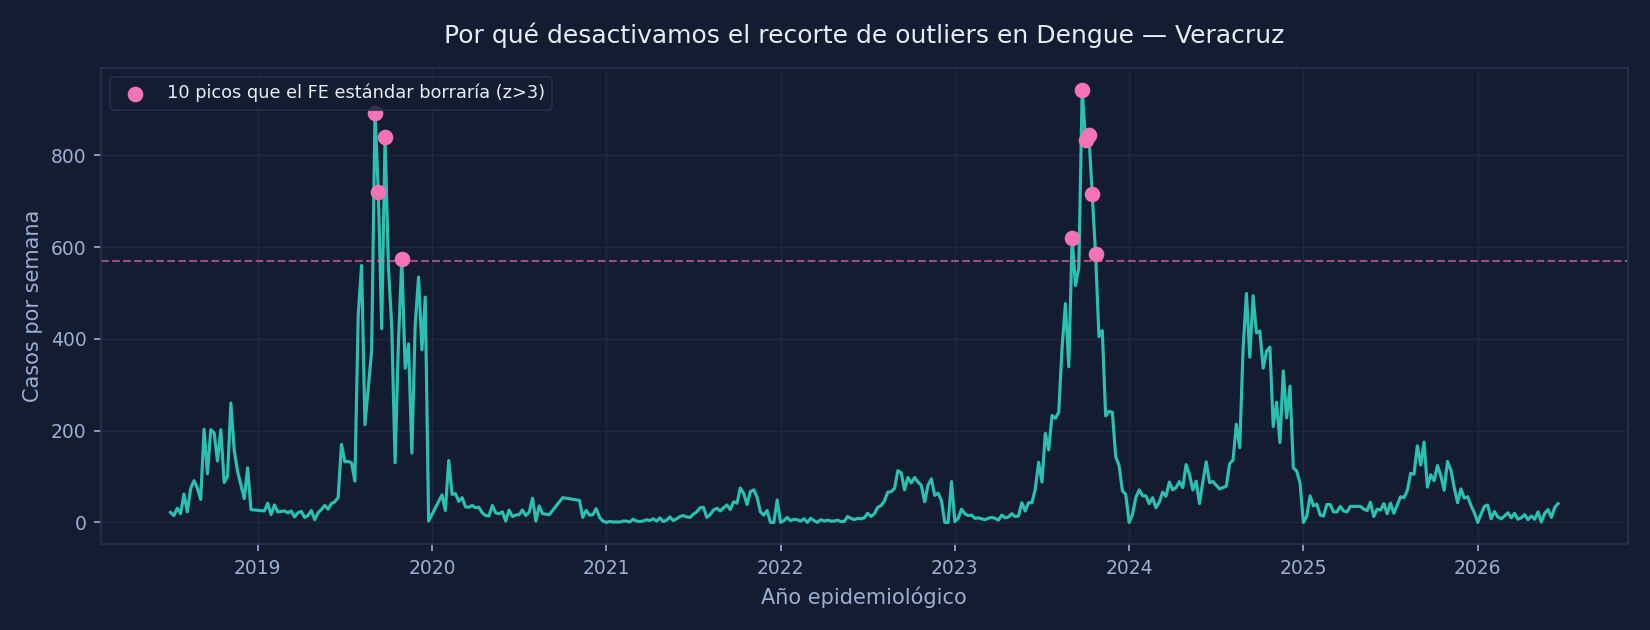
Aquí tomamos una decisión deliberada y contraria al tratamiento estándar. El pipeline normalmente recorta los valores extremos (z-score > 3 reemplazado por la mediana) para suavizar ruido. En una arbovirosis eso sería un error grave: el brote epidémico es exactamente lo que queremos pronosticar, no una anomalía a borrar. Aplicar el recorte habitual eliminaría 334 semanas-estado de picos reales. Por eso, para Dengue desactivamos el recorte de outliers, ya configurado en el pipeline de preparación: las 12,544 filas se conservan sin alterar y los picos epidémicos llegan intactos al modelo.
Ejemplo (Veracruz): los puntos resaltados son picos epidémicos reales que el recorte estándar reemplazaría por la mediana. Para Dengue, se conservan.
Feature engineering a la medida del dengue
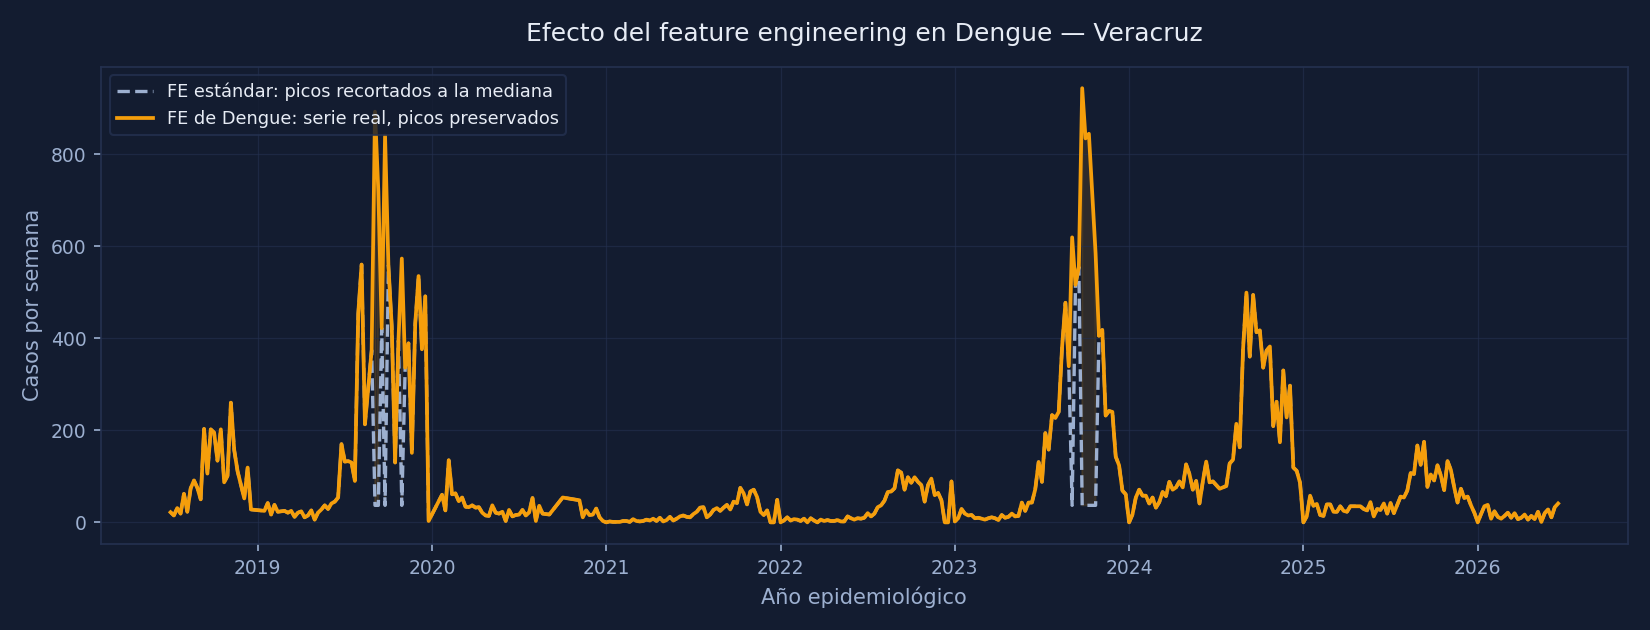
El dengue no se parece a una enfermedad crónica: es un fenómeno climático y biológico que estalla en brotes (como se ve en el mapa y en el ciclo de aproximadamente cuatro a cinco años, ligado a El Niño) y se apaga en temporada baja. Por eso no reutilizamos el feature engineering de los padecimientos neurológicos: lo rediseñamos pieza por pieza para la dinámica del mosquito. La decisión más visible es la de los outliers: el siguiente gráfico contrasta la serie real (lo que conserva el feature engineering de Dengue) contra lo que dejaría el recorte estándar, que aplanaría los brotes a la mediana.
Efecto del feature engineering (ejemplo Veracruz): el FE estándar (línea punteada) aplanaría los picos epidémicos de 2023 y 2024 a la mediana; el FE de Dengue (línea ámbar) los conserva como la señal a pronosticar.
Los demás ajustes del modelado para Dengue:
Estacionalidad
Multiplicativa
La amplitud de la temporada crece con el nivel de casos; la estacionalidad anual es el componente dominante.
Tendencia
Cambios más flexibles
Los brotes arrancan de forma abrupta; el modelo permite quiebres de tendencia más marcados que en las series neurológicas.
Régimen COVID
Sin ajuste pandémico
2020-2022 no fue una disrupción para el dengue (siguió su ciclo natural); no se aplicará el tratamiento especial de ese periodo que sí usan los modelos de salud mental.
Escala
Conteos absolutos
Se modelan los casos directos (no la tasa por población): en una arbovirosis con niveles muy bajos en temporada baja, la tasa por 100 mil comprime la señal y degrada el pronóstico.
Decisión: si es cero, es cero (sin fallback)
Para las entidades neurológicas, una serie con pocos datos hereda el patrón de su región. Para Dengue la decisión es no usar ese fallback regional: una entidad sin transmisión no debe heredar la curva epidémica de un estado tropical. Si una entidad no tiene dengue, su pronóstico es cero.
El caso de la Ciudad de México
Históricamente la altitud de la Ciudad de México (2,240 m) impedía al mosquito Aedes aegypti, y nuestros datos lo confirman: cero casos confirmados en todo el periodo. Pronosticar cero ahí es lo correcto; pedir prestado el patrón de Veracruz sería absurdo.
El matiz: el mosquito ya está colonizando la ciudad (detectado en 14 alcaldías) y en 2025 se reportaron los primeros casos locales. Por eso no fijamos un cero permanente: cada entidad se modela con sus propios datos, de modo que el pronóstico se actualizará solo cuando el dengue empiece a aparecer en el boletín.
Fase 3 · Entrenamiento
Entrenamiento y validación: cinco motores, sin fuga de datos
Con la serie ya lista, entrenamos los cinco motores de pronóstico del proyecto sobre el Dengue. Lo decisivo no es solo qué modelos usamos, sino cómo los validamos: con un esquema temporal estricto que evita la fuga de información del futuro hacia el pasado (data leakage), para que las métricas sean honestas y comparables entre motores.
Los cinco motores
Prophet
Tendencia + estacionalidad
Estacionalidad anual multiplicativa sobre escala logarítmica, que estabiliza la varianza entre temporada alta y baja. Lleva un regresor de El Niño (índice ONI). Motor productivo del Dengue.
DeepAR
Red neuronal (GluonTS)
Red recurrente probabilística entrenada sobre la serie nacional agregada, con dos años de contexto. Captura bien la dinámica epidémica. Motor productivo del Dengue.
NB-GLM
Conteos + Fourier + El Niño
Modelo lineal generalizado Negative-Binomial (la distribución correcta para conteos) con estacionalidad de Fourier, rezagos y el índice El Niño (ONI). Suspendido en esta ronda: su predicción recursiva (cada semana pronosticada alimenta la siguiente) se desboca más allá de unas diez semanas, así que no se publica ningún pronóstico suyo. Sus modelos se conservan como evidencia.
Ensemble
Prophet + XGBoost
Prophet modela la estructura y XGBoost aprende los residuos con rezagos y medias móviles (todos sobre el pasado, sin mirar el presente).
Stacking
Prophet + ETS + LightGBM
Varios expertos combinados por un meta-modelo con pesos no negativos sobre predicciones fuera de muestra.
De cinco entrenados, dos elegibles en esta ronda
Se entrenan y evalúan los cinco motores, pero sólo Prophet y DeepAR son elegibles en esta ronda; entre ellos se elige el productivo de cada serie (—). Ensemble y Stacking no son elegibles para Dengue, y NB-GLM está suspendido.
Los componentes de árboles de Ensemble (XGBoost) y Stacking (LightGBM) no extrapolan bien la dinámica epidémica a 52 semanas y se disparan al alza. Es una limitación conocida de los modelos de árboles en horizontes largos, no un defecto de los datos. NB-GLM se suspendió porque, al encadenar sus propias predicciones semana a semana, muchas series crecen sin control hasta el tope del modelo; restituirlo exige corregir esa recursión, reentrenarlo y volver a calificarlo.
Fechas y validación cruzada
Toda la validación es temporal (TimeSeriesSplit): cada pliegue entrena con el pasado y se evalúa en el futuro inmediato, nunca al revés. El corte entre entrenamiento y validación es el 1 de enero de 2025, igual para los cinco motores.
2025-01-01
Corte entrenamiento / validación
322
Semanas de entrenamiento
69
Semanas de validación (holdout)
52
Horizonte de pronóstico
La validación cruzada se ajusta a cada motor: Prophet usa 4 pliegues de 53 semanas; DeepAR nacional, 2 pliegues de 26 semanas (cada pliegue conserva suficiente historia para entrenar sin relleno artificial); Ensemble y Stacking, pliegues temporales sobre los residuos y predicciones fuera de muestra. El pico epidémico real de 2024 queda en entrenamiento y la validación se mide sobre 2025-2026.
Sin fuga de datos (data leakage)
Cuatro candados
Validación temporal: ningún pliegue se evalúa con datos que vio al entrenar; el orden cronológico se respeta siempre.
Holdout honesto: las métricas se miden en las 69 semanas posteriores al corte (2025-2026), que el modelo de evaluación no vio.
Features solo del pasado: los rezagos, medias móviles y tasas de cambio se calculan con un desfase de una semana; nunca usan el valor presente ni el futuro.
Modelo productivo vs evaluación: el modelo que genera el pronóstico a 52 semanas sí se ajusta con toda la historia disponible (lo correcto para pronosticar el futuro); las métricas que comparan motores salen siempre del esquema temporal de arriba, no de ese ajuste completo.
Una nota honesta sobre las cifras: en una serie epidémica con saltos de cero a decenas de miles de casos por semana, los errores porcentuales (SMAPE) son altos por construcción en las semanas de baja transmisión. Por eso la selección del motor productivo no se queda con un solo número, sino que pondera el desempeño sobre la realidad reciente del boletín.
Una salvedad honesta sobre la selección
Hay que distinguir dos cosas. La comparación entre familias de modelos sí usa el esquema temporal de validación de arriba (honesto). En esta ronda, el motor productivo de cada serie se eligió fuera de muestra: los modelos se entrenaron con los boletines hasta la semana 27 de 2026 y se compararon contra las semanas 28 a 37, que no habían visto; después, el motor elegido se reentrenó con la historia hasta la semana 37 para producir el pronóstico. Esa comparación sirve para elegir el motor; no es una medida publicada del desempeño del pronóstico.
Para medir el desempeño de forma genuinamente fuera de muestra congelamos el pronóstico vigente y lo comparamos, semana a semana, contra los boletines que llegan después del corte (que el modelo no vio). Ese seguimiento prospectivo es el que dirá si la selección se sostiene en datos nuevos; mientras tanto, lo reportado de 2026 debe leerse como ajuste reciente, no como pronóstico verificado.
El pronóstico
Lo que viene: el pronóstico a 52 semanas
Con los modelos entrenados y calificados, el sistema genera el pronóstico productivo: para cada serie (entidad y sexo) se usa el motor asignado entre los elegibles de esta ronda, Prophet y DeepAR. A nivel nacional el motor productivo es —. El pronóstico cubre 52 semanas; no publicamos proyecciones a varios años.
—
Series con DeepAR
—
Series con Prophet
52
Semanas de pronóstico
Por qué no hay proyección a varios años
El dengue tiene grandes brotes cada cuatro a cinco años (2014, 2019, 2024), ligados a El Niño. Con tan pocos ciclos en los datos, ni el momento ni la magnitud del próximo brote pueden pronosticarse con fiabilidad. Por eso publicamos sólo el pronóstico a 52 semanas; la proyección multi-año que se mostraba antes, basada en NB-GLM, se retiró junto con ese motor.
Cuadro en vivo
Las cifras, como en el boletín
Esta tabla reproduce el cuadro del último boletín procesado, ya agregado a "Dengue total". Se alimenta del dato publicado por el proyecto: cuando llega un boletín nuevo y se regenera la serie, las cifras de abajo se actualizan solas.
En vivoCargando datos…
Entidad federativa
Casos (semana)
Acum. hombres
Acum. mujeres
Acum. total
Cargando el cuadro…
Dengue confirmado agregado (A97.0 + A97.1 + A97.2). Acumulados del año en curso. Fuente: boletines epidemiológicos del SINAVE / DGE / Secretaría de Salud.
Fuentes
Referencias
Fuentes oficiales de los datos y del contexto epidemiológico de esta página.
Fuente primaria de los datos
DGE · Boletín Epidemiológico (SINAVE)
Boletín epidemiológico semanal de la Dirección General de Epidemiología, órgano oficial de difusión del SINAVE, de donde EpiForecast-MX extrae y valida la serie de Dengue confirmado (cuadro de Enfermedades Transmitidas por Vector).
Reportes semanales de la Dirección General de Epidemiología sobre dengue y dengue grave en México (Sistema Especial de Vigilancia Epidemiológica de Dengue).
OPS/PAHO · Actualización epidemiológica de dengue en las Américas (2024)
2024 fue el mayor número de casos de dengue en las Américas desde 1980 (cerca de 12.9 millones de casos sospechosos); México figuró entre los cuatro países que concentraron el 90% de los casos.
Población por entidad federativa, usada como contexto demográfico del proyecto. El Dengue se modela sobre conteos absolutos; los padecimientos neurológicos sí se normalizan a tasa por cada 100 mil habitantes.
Las cifras citadas (récord de 2024 en las Américas, concentración geográfica, ciclo epidémico ligado a El Niño) están respaldadas por las actualizaciones de OPS/PAHO y la OMS enlazadas arriba.